记录 LobeHub 的 Electron 更新实践,从 Renderer OTA 的兼容性困境到 Shell/Core 拆分、内容寻址差分、Pack 与 Range 下载、启动回滚,以及 Sparkle 补丁链。
页边批注为本站的阅读理解与实践补充,不属于原文。
其实对 Electron 这方面的更新,我也已经有过很长时间的探索了。
最早是在做 Folo 的时候,我给它做过一套 renderer 层的 OTA。那套东西完全是我自己手搓的,没有借助 AI。当时没有考虑太多,很多边界情况没处理好,架构也谈不上好。
到了 LobeHub,我接着把这件事往下做。这一轮是一次次改出来的,按 PR 大致能串成这样:
- 8 月 24 日,renderer 热更新上线,不重启 App 就能换掉前端。
- 之后几天连着改 OTA 包:gzip 压缩,只保留基线和最近两个增量、按发布版本隔离、换成 V2 包格式。
- 9 月 12 日,在 macOS 的 canary 渠道试 Sparkle 差分更新,这个 PR 还没合并。
- 9 月 28 日,把 app.asar 拆成一层很薄的 shell 和一个带签名、能单独 OTA 的 core,支持 reload、relaunch 和回滚。
- 9 月 29 日,内置 core 也打包成 ASAR,OTA 包支持按范围下载。
常规的 Electron 更新,最常规的方式就是直接全量更新,通过 electron-updater 就可以完成。
为什么我不想用 electron-updater 的全量更新
在 LobeHub 里,一次全量更新从 App 退出到重新打开,差不多要 10 秒。我平时用 Mac,这 10 秒每次发版都得等一遍。macOS 上 electron-updater 底层走的是 Squirrel.Mac:先把新版本完整的 zip 下载下来,等 App 退出后,再由一个叫 ShipIt 的进程把整个 .app 替换掉,最后重新拉起。
electron-updater 也不是每次都下全量包,它有一套增量下载机制,叫 blockmap。可这套机制在我这里有两个问题:生成慢,而且小版本升级照样要下好几兆。
blockmap 怎么省流量
打包的时候,electron-builder 会把安装包切成很多小块,每块十几 KB,给每一块算一个指纹,存进一个 .blockmap 文件。更新时,客户端拿新旧两份 blockmap 逐块对比:指纹一样的块从本地旧包里直接复制,只有指纹变了的块才去下载。
思路没有问题,问题出在它切的是压缩之后的安装包。
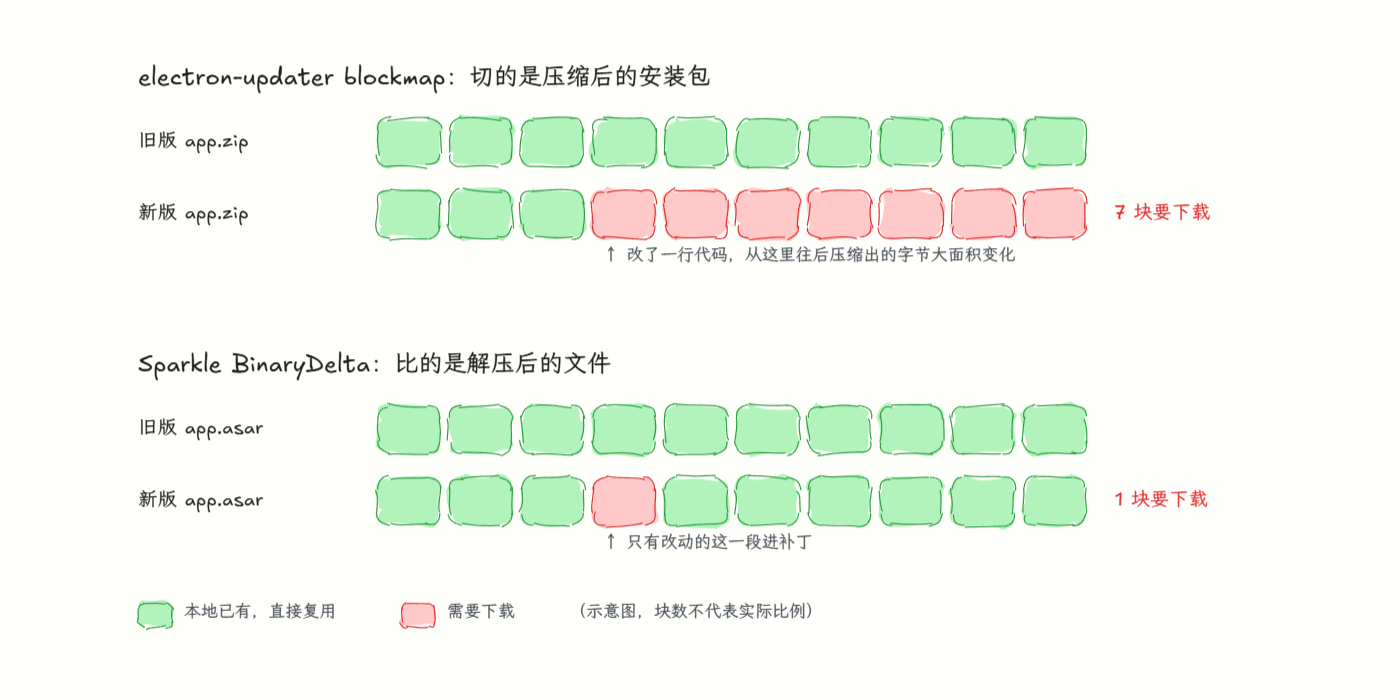
先看上半部分。压缩有点像把一整本书改写成速记:原文只改了一个字,速记从这个字开始往后的写法可能整段都变了。于是改动点之前的块还能对上,之后的块大面积对不上,客户端只能把它们重新下一遍。偏偏业务代码全在 app.asar 里,它是安装包里最大的文件,几乎每次发版都会动到它。
asar 自己也在放大改动。它的文件头是一张目录表,记着每个文件从第几个字节开始。某个文件多了几个字节,排在它后面的文件起始位置全都要改,这张表也跟着大半重写。
再看下半部分,Sparkle 走的是另一条路。它的 BinaryDelta 工具直接比较旧版和新版两个 .app 目录:没变的文件不进补丁;变了的文件用 bsdiff 算出二进制差异,补丁里只记“哪里改了、改成什么”。比较发生在解压之后,所以改一行代码,补丁大小基本只跟真实改动的量有关,不会被压缩放大。
至于生成慢:blockmap 要在每次打包时把整个安装包从头到尾扫一遍,逐块算指纹。在 LobeHub 的 CI 里,这一步本身就要等上一阵。
renderer 层 OTA:不用动 asar
最简单的是 renderer 层的 OTA,它甚至不需要动 asar。
为了说清楚为什么不用动 asar,先简单过一下 asar 里有什么。
app.asar 是 Electron 打包后的应用代码归档,结构上类似一个 tar 包。启动时,Electron 先读取里面 package.json 的 main 字段,执行主进程入口;主进程再创建窗口,把 renderer 加载进来。
一个完整的 asar 里一般有三部分:main、preload 和 renderer。关键在于,窗口加载哪个地址是我们在 main 里自己写的(win.loadURL() 或 win.loadFile()),并不要求它一定来自 asar。所以可以在 App 里打包一份 renderer 当兜底,之后把新版本的 renderer 下载到 asar 外面,让窗口直接加载新的那份,这就实现了 renderer 的 OTA。
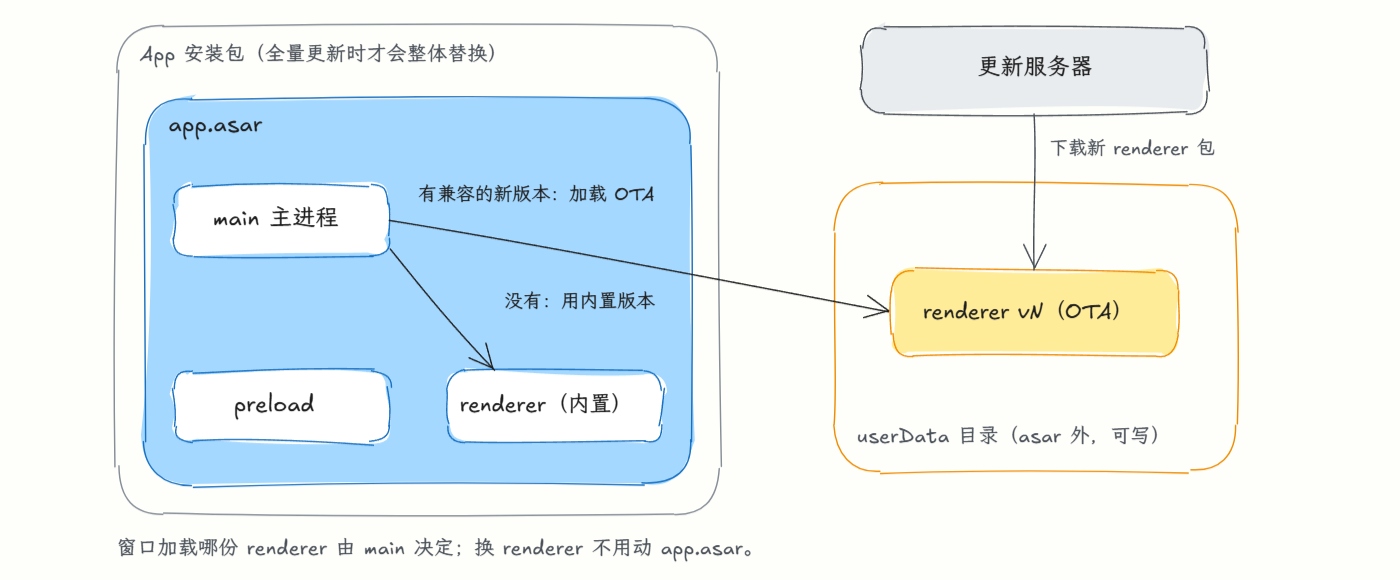
图里 asar 中的 main 和 preload 始终不变。main 启动时检查 userData 里有没有和自己兼容的新 renderer:有就加载那份,没有就回退到 asar 里内置的版本。
为了做防篡改,所以我们需要进行签名和验证。
当然,最开始那一版在 Folo 里面并没有考虑那么多,所以这种防篡改的能力其实根本就没有做。后来在 LobeHub 里,我们给产物加上了公私钥签名校验。
这里的难点在于:你如何能够确定你的这一次发布是能够命中 OTA,还是应该走全量?
能够走到 OTA 的前提条件是:
- main 的 ABI 没有改变
- Electron 的版本没有改变
- main 的依赖没有改变
之前在 Folo 里面使用的是扁平的项目结构,并不存在 workspace 中有非常多的共享 package。这个 package 不会存在既在 main 中被使用、又在 renderer 中被使用的情况。
但是在 LobeHub 中,这种情况被放大了。在整个项目的 workspace package 依赖树中,它会表现得更加复杂:你无法判断一个子包中的代码被修改了,它能否触发 OTA;如果稍有不慎,也有可能会导致因为 ABI 的问题而报错。
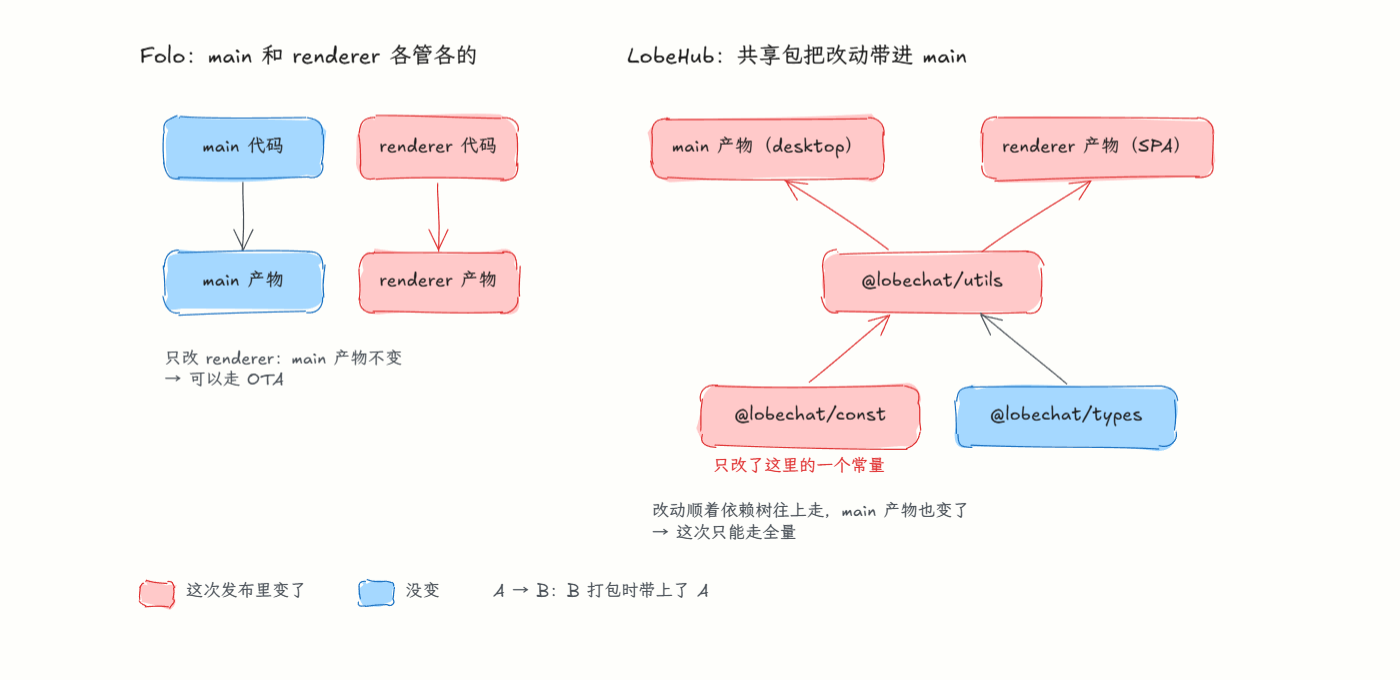
拿 LobeHub 里真实的依赖举例:@lobechat/const 被 @lobechat/utils 引用,而 @lobechat/utils 同时被 desktop 的 main 和 renderer 引用。只改 const 里一个常量,看起来是前端的事,main 的产物却也跟着变了。依赖树越深,这条路径越难靠肉眼看出来。
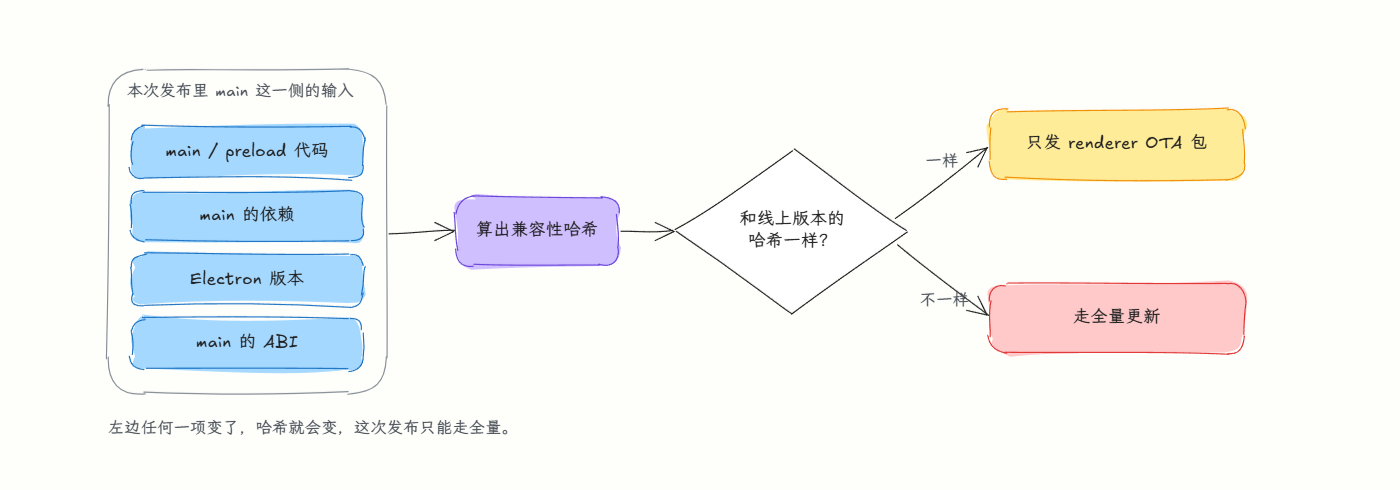
也就是说,一旦 preload 和 main 的代码或者依赖的产物有变动,那么就不能考虑 renderer OTA 了。
为了解决这个问题,我们后续又提了一连串 PR 去改进,想让判断命中得更准、粒度更细,搞清楚这次发布到底要不要、能不能走 OTA:给 main 的产物算哈希、改成从源码输入推导兼容性、稳定兼容性判定和全量发布状态。
但事实证明,这个方案的复杂度非常高。到 renderer OTA 被替换掉之前,光是判断“这次能不能 OTA”的脚本就有将近一千行:mainHash.mjs 469 行、mainHashGraph.mjs 376 行、validateMainHash.mjs 118 行,配套测试还有 582 行。这套算法是借助前沿模型一起写出来的,可读性和可维护性却真的非常差。
只是为了 OTA 一个 renderer,就要写这么长、这么复杂的算法去做判断。回头看,我觉得这个方案的方向本身就错了。
换个方向:asar 只做引导器
Discord 的本体应用里不打包任何业务代码,它的 asar 只是一个资源引导器。这也带来了一个很让人诟病的问题:每次下载完 Discord 打开,总会先弹出一个 update 小窗;网络不好的话,可能要等非常久。
我们也可以沿着 Discord 的思路走:把 asar 当成引导器,由它去载入 main 层和 renderer 层的代码。这样以后就不用再考虑 renderer 更新会不会受 main 影响,只需要看 main 依赖的底层有没有变,就能判断这次该走全量还是 OTA。
这里的底层指的是:Electron 版本一旦升级或改变,ABI 就会跟着变;此外还有原生的 native 代码和 native bindings。
不过我并不认同 Discord 把实际代码完全留在 App 本体之外的做法。所以我们吸收它的优点,再加上自己的一点:把业务代码作为一份基底,同样打包进 App。这样刚装好的 App 不用联网就能直接打开。
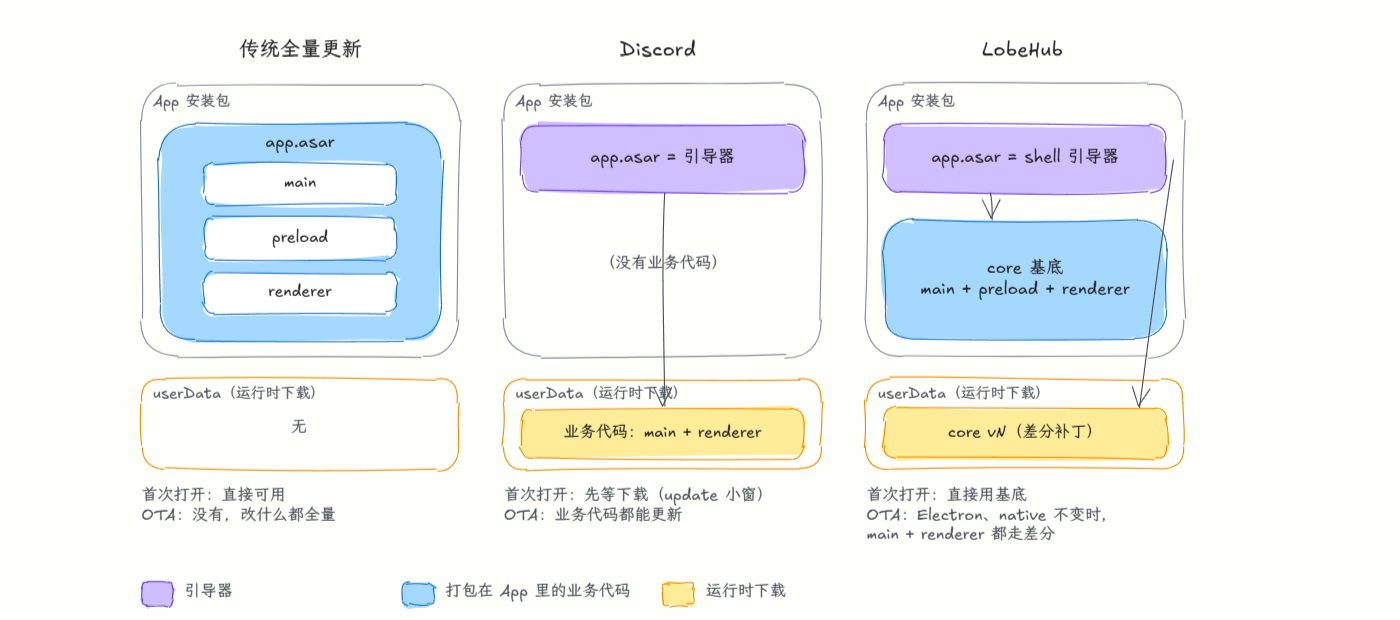
三种做法的差别在于业务代码放在哪。传统做法全塞进 app.asar,没有 OTA 的余地;Discord 全放在外面,首次打开只能先等下载;LobeHub 两头都占:安装包里带一份 core 基底,打开就能用,之后的新版本以差分补丁的形式下到 userData,由 shell 决定加载哪一份。
后续的 OTA,则用前面提到的、类似 Sparkle 的差分更新。
先在 Canary 上验证
这次迁移,我们先在 Canary 频道上验证。Canary 每次合入分支都会触发一次更新,节奏非常快。
按传统方式全量构建,等所有安装包出来,9 月底那几天的中位数是 64 分钟,最快一次也要 43 分钟;走 OTA 之后,只动 renderer 的发版中位数 4.3 分钟,现在的 core OTA 在 runner 空闲时端到端 8 分钟左右就能发完,ship 的速度大幅提升。
core 怎么做增量
另外要考虑的是 OTA 怎么做增量。一个完整、经过全量压缩的 App 大约 200 MB;而 core 的产物如果不压缩、整包下载,也要 100 多 MB,省不了太多。所以我们对 core 里的文件做了内容寻址,这样后面也能支持跨版本的增量更新。
这部分改过两版:9 月 28 日合并了一版,9 月 29 日又改了一版。先说 9 月 28 日那版(#19501)。
CI 发版时,core 里的每个文件都按 sha256 算出指纹,以 objects/<sha256>.zst 的形式单独上传。如果旧版本里有对应的文件,再额外生成一份 zstd 差分补丁 patches/<旧 sha256>-<新 sha256>.zst。manifest 里记下整棵文件树:每个路径对应哪个 sha256、多大。
这里的差分补丁用的是 zstd 的字典压缩:把旧文件当成字典,去压缩新文件。zstd 压缩时会在字典里找重复的片段,没变的部分只需要记一句“从旧文件第几个字节开始,复制多长”,只有真正改过的字节才会写进补丁。客户端拿同一个旧文件当字典解压,就能还原出新文件,再用 sha256 校验,对上了才写入。
哪个旧文件配哪个新文件,也有讲究。内容相同的直接复用;路径相同的做补丁。Vite 的产物文件名里带着内容哈希(index-a1b2c3d4.js),改一行代码文件名就变了,所以还会去掉这段哈希,再按名字配对。补丁只给 renderer 和 CLI 的文件做;新文件小于 16 KB,或者补丁超过新文件一半大小时,就不做补丁,直接下完整对象。
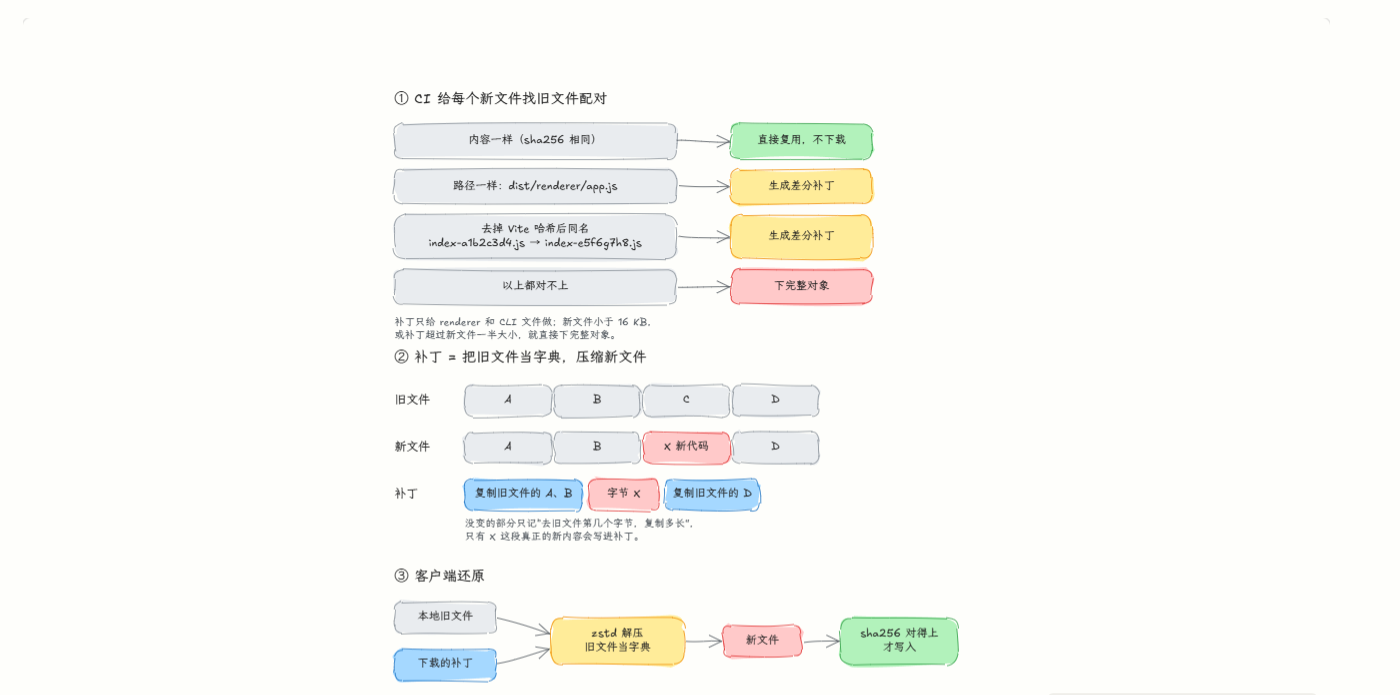
客户端拿到 manifest 后,先对照本地已有的文件(内置基底、当前版本、对象缓存)算出缺哪些 sha256。缺的文件优先下差分补丁,在本地旧文件上打出新文件;没有补丁就下完整的对象。缺得太多(超过 400 个)或者中途失败,就退回去下整包。最后按文件树把对象一个个链接或复制到新版本的目录里。
因为是按内容而不是按版本号找文件,跳过几个版本再更新也没问题:只要某个文件的内容在本地出现过,就不用再下载。
这一版的问题出在安装上:core 里有几千个零散的小文件,安装时要一个个复制,小文件复制非常慢。这也是 9 月 29 日又把 core 改成 asar 的原因,后面细说。
第二版:core 打成 asar,OTA 走 Range
9 月 29 日我又发现前一天的方案也不好,主要有这几个原因:
- 每次生成 OTA 时,一个 JS 文件就对应 S3 上的一个对象,上传操作太多。
- 400 个文件的上限没有按实际大小去算:缺的 401 个文件加起来哪怕只有 300 KB,也会去下全量,这不合理,应该按实际体积来判断。
- 差分完之后,userData 里存的还是平铺的全量散文件。
于是就有了 9 月 29 日的改动(#20191):
- 再用 asar 把 core 封装一次,安装包里放的是一个
core.asar,而不是几千个散文件。 - CI 上的 OTA 产物也合并了一次:把所有 zst 帧合成一个文件,客户端再按 HTTP Range 去取需要的那几段。
- 加载业务代码时按优先级搜索:先找有没有可用的 OTA 版本,没有再 fallback 到内嵌的
core.asar。
合并后的文件叫 pack:每个文件压好的 zstd 帧原样首尾拼接,不再套一层 ZIP,也不整体再压缩。manifest 里记下每个文件在 pack 里的偏移和长度,这份索引和其他字段一起签名。客户端算出缺哪些文件后,只发 Range: bytes=起点-终点 请求去取对应的片段,相邻的片段合并成一个请求。每个片段下完先校验压缩后的哈希,解压后再校验一次内容哈希。
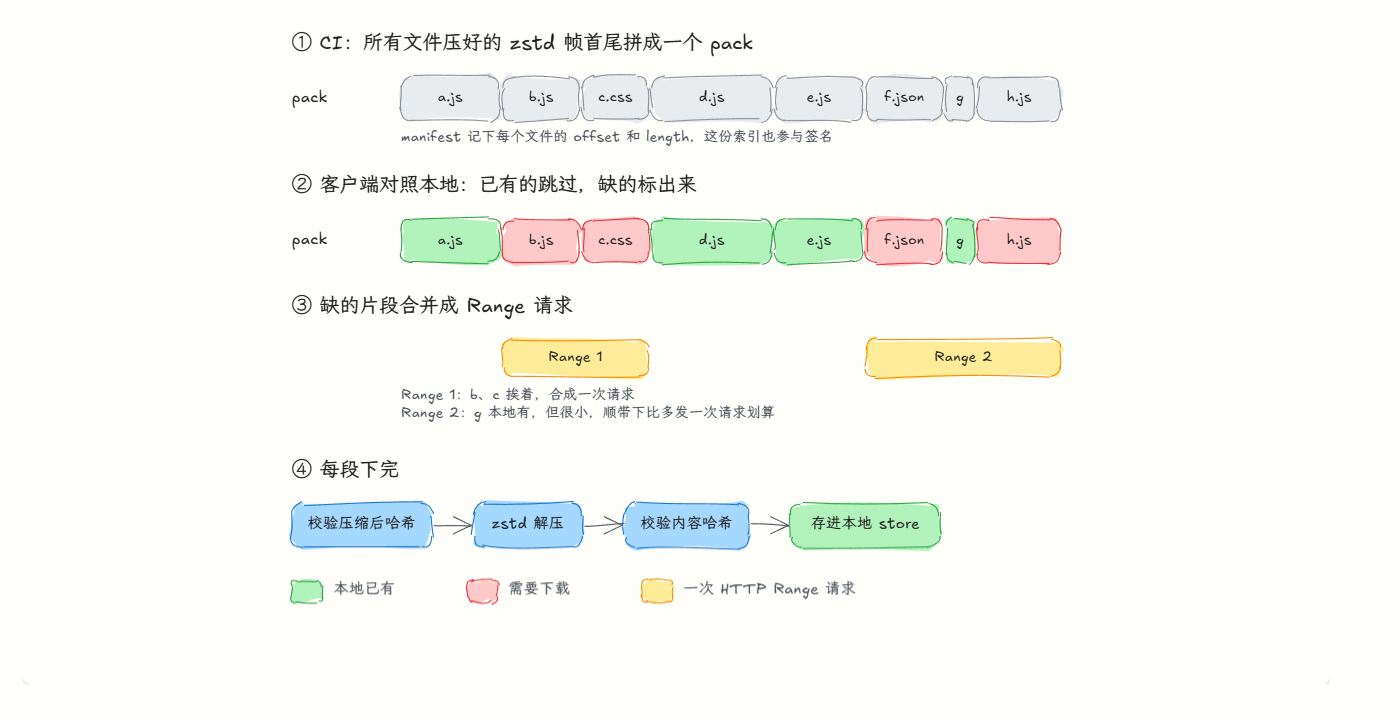
400 的上限也去掉了。下片段还是下整包,改成按估算耗时来选:预计耗时 ≈ 传输字节数 ÷ 吞吐量 + 请求轮数 × 单次请求延迟,哪个方案小就用哪个。
启动时,shell 依次找:待生效的新版本(staged)→ 当前版本 → 上一个版本 → 内置的 core.asar。每个候选都要过几道检查:ABI 和 shell 对得上、manifest 签名有效、渠道一致、版本比内置的新。一个版本连续 3 次启动失败会被拉黑,自动退到下一个候选。
散文件:量过之后决定不改
前面的第 3 个问题,我本来打算把 userData 里的 OTA 版本也组装成 asar。真量了一遍,结论反过来了。
一个 OTA 版本大约 1700 个文件、111 MB,其中 40% 的文件不超过 4 KB。但组装发生在后台下载之后,不在启动路径上:macOS 从一个 OTA 版本切到下一个要 300–340 ms;Windows 上一次真实的首次 OTA,下载 10.3 MB、组装 1707 个文件,端到端 4.19 秒。
磁盘也没有想象中浪费。store 和各个版本目录都在 userData/core-ota 下,版本之间没变的文件用硬链接共享同一个 inode,多保留一个版本实际多占 0 KB;保留的版本也只有 current、previous 和待生效的 staged。唯一的重复是第一次 OTA:要把整个版本从内置的 core.asar 里写出来一份,约 108 MB,这一份改成 asar 也省不掉。反过来,如果每个版本都打成一个 asar,版本之间就没法共享 inode,current 加 previous 的磁盘占用接近翻倍,还得为改布局专门发一次完整安装包。所以散文件留着。
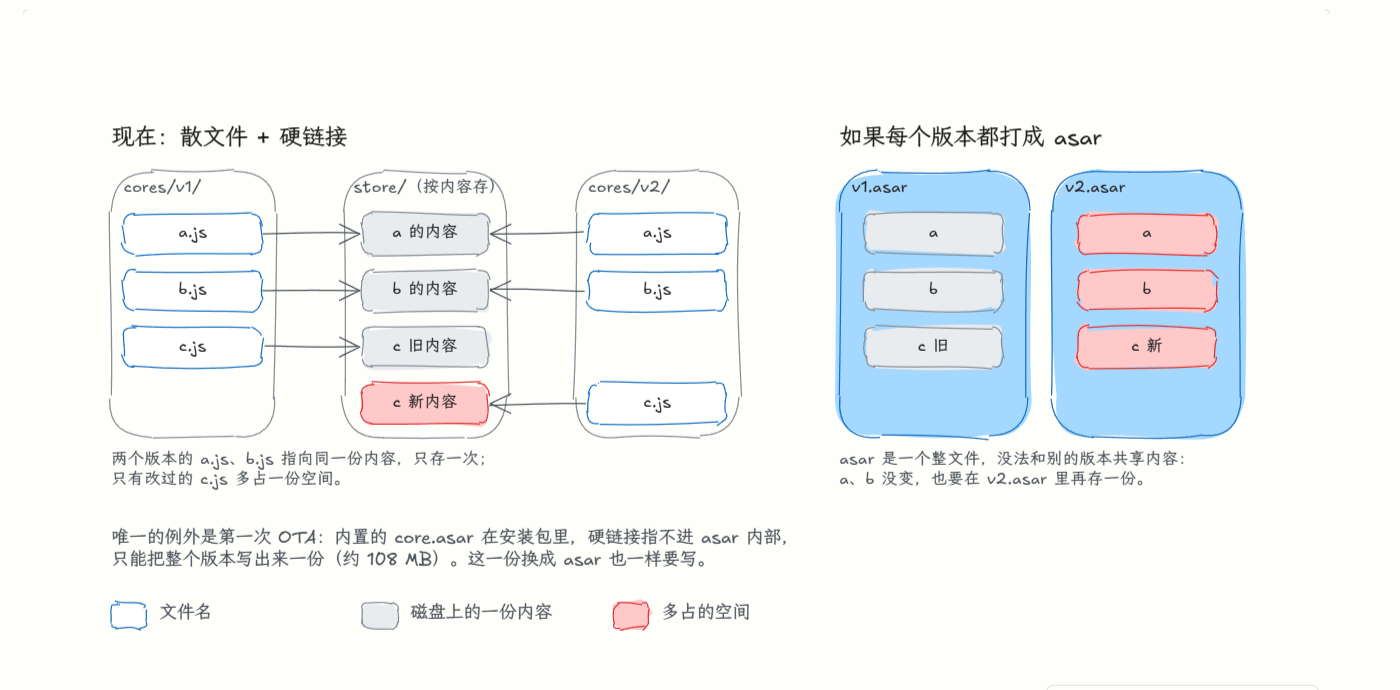
硬链接可以理解成给磁盘上同一份内容起第二个文件名。左边的 cores/v1/a.js 和 cores/v2/a.js 是两个名字,背后是 store 里同一份数据,所以多留一个版本,只有真正改过的文件会多占空间。右边的 asar 是一个完整的大文件,没法和别的版本共用里面的内容,每个版本都是一整份。
文件校验只该在更新时做
量数据的时候还发现了一个问题:shell 每次启动都会把当前 OTA 版本里的每个文件读一遍、算一次 sha256,而且是在窗口出现之前。更新阶段其实已经校验过了:CoreStore.assemble 在临时目录里给每个组装出的文件算哈希,通过后才换到正式目录、标记 staged。启动时这一遍是重复的。
#20211 把启动检查改成逐个文件 stat:只看文件在不在、大小对不对,签名、shellAbi 和入口文件的检查都保留。在同一个真实 OTA 版本(1706 个文件、111 MB)上,resolveCore 的耗时:
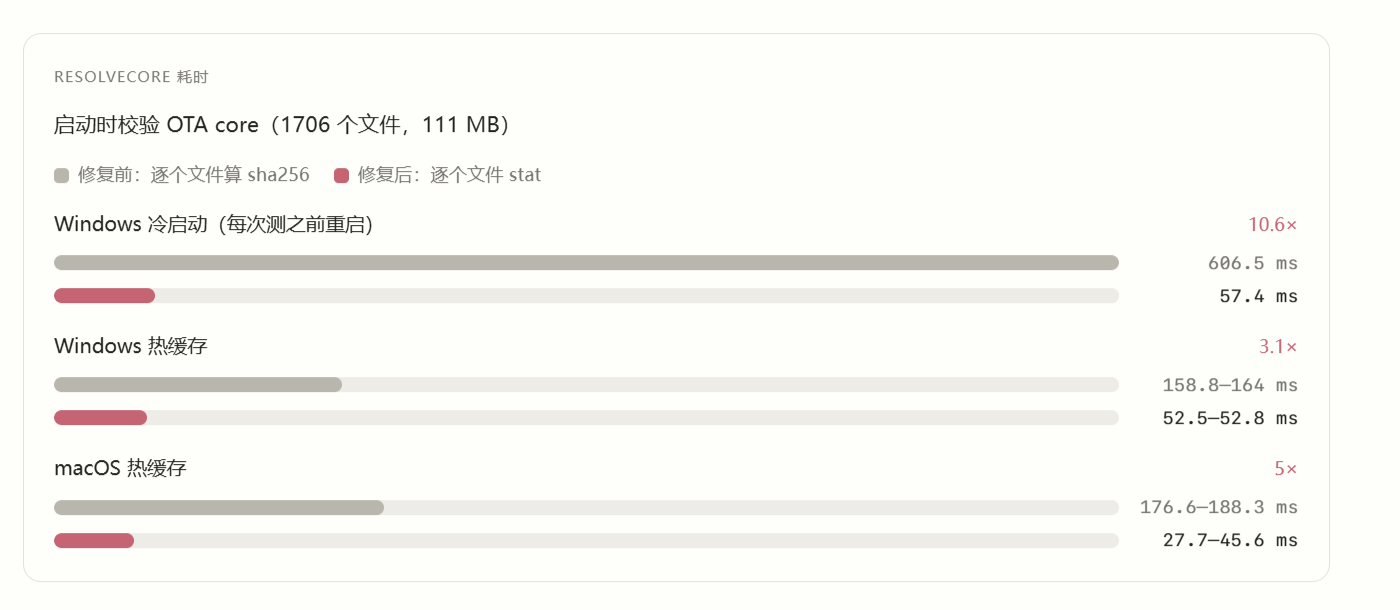
Windows 测试机是 i5-13600KF + NVMe,关着 Defender 实时保护,算是最好的情况;macOS 是 M4 Max。开着杀毒软件的普通 Windows 机器上,修复前的数字只会更难看。
代价是:组装完成之后,如果有人在本地改了 userData 里的文件、又恰好没改变大小,启动时发现不了。截断、删除、被杀毒软件隔离这类情况仍然会被拦下。能随意写 userData 的程序本来就有很多别的办法影响 App,这个取舍我能接受。另外这个改动动的是 shell,按 shellAbi 的规则,只能跟完整安装包一起发。
CI 上快了多少
我从 GitHub Actions 里拉了 9 月 25 日到 29 日所有成功的 Canary 发版,按这次走的路径分类,统计从第一个 job 开始到最后一个 job 结束的时间:
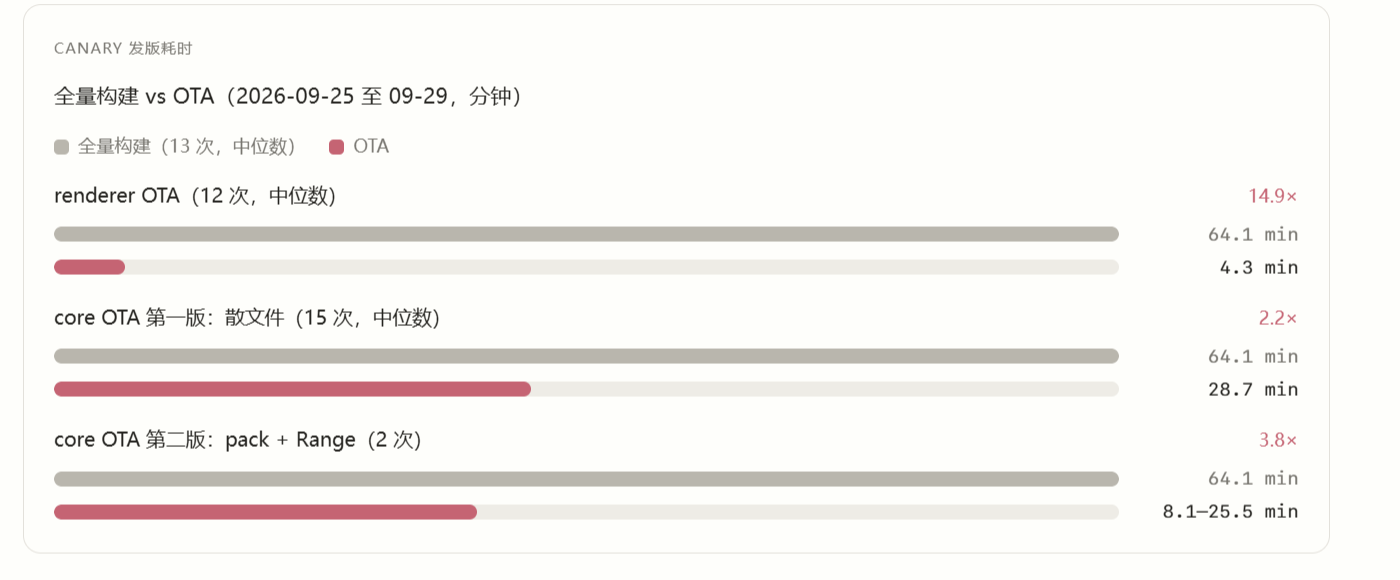
全量构建慢在 macOS:Apple Silicon 的构建 job 要 16–24 分钟,那几天还带着 Intel 版本,一个 job 就是 28–45 分钟,之后还要合并 macOS 产物、发布、上传 S3。OTA 只构建 core,第二版每个平台的构建 job 只要 3.5–5 分钟。
core OTA 的整条流水线比单个 job 长很多,时间花在排队上。比如 9 月 29 日 12:00 那次,三个平台的构建各自只要 4 分钟左右,却是一个接一个等到 runner 才开始跑,整条流水线用了 25 分钟。runner 空闲的时候,最快一次端到端是 8.1 分钟。
reload 还是 relaunch
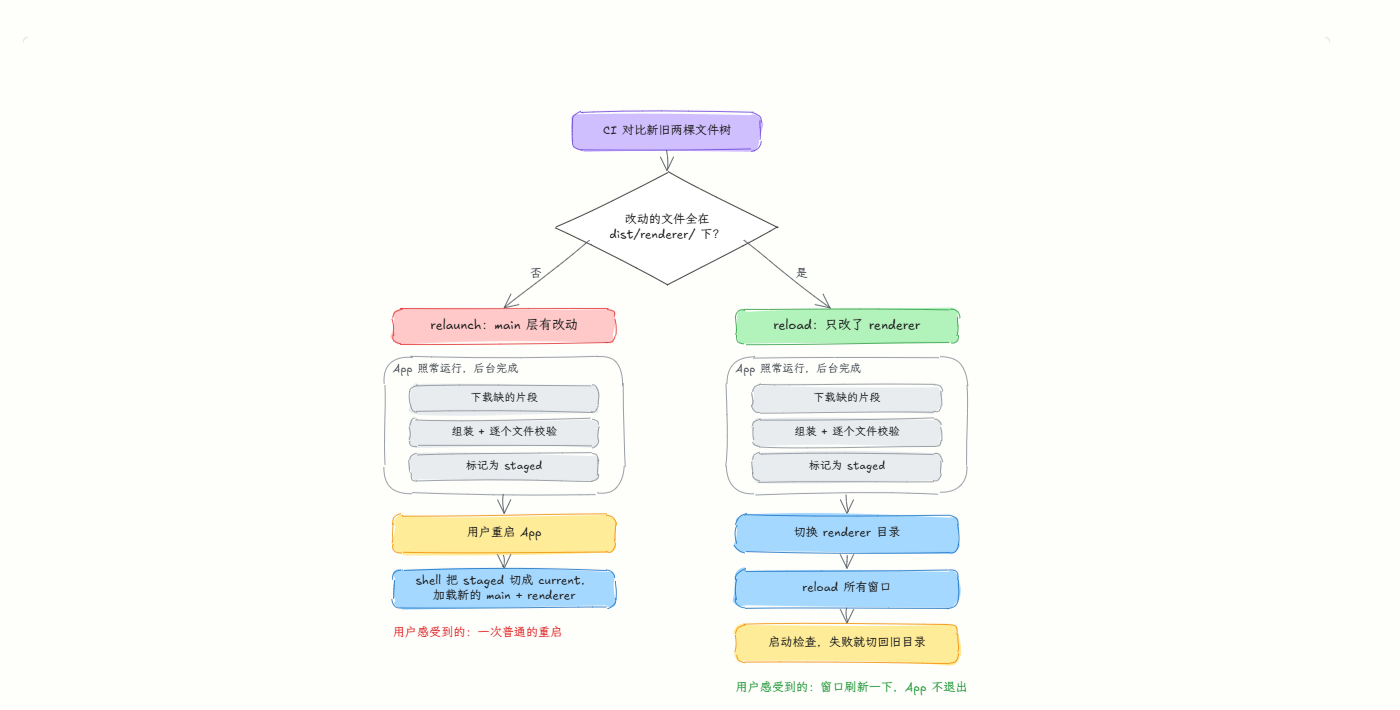
这套拆分还有一个好处:能很明确地知道这次改的是 renderer 层还是 main 层。判断很直接:CI 对比新旧两棵文件树,改动的文件全在 dist/renderer/ 下就标成 reload,否则标成 relaunch。
- main 层有改动:退出 App 再重启一下就好。下载、组装、校验在 App 运行时就已经在后台做完了,重启时 shell 直接切到新版本,相当于只是重新启动一次。
- 只有 renderer 层有改动:App 都不用退出,把 renderer 的目录切到新版本,reload 一下窗口就行。reload 之后还会做一次启动检查,新版本起不来就切回原来的目录。
下一步:Stable 换成 Sparkle
现在这套 OTA 只在 Canary 上跑,因为 Canary 发版非常频繁;Stable 目前还没有用 OTA。Stable 这边还是要解决全量更新慢的问题,我的答案是把 electron-updater 换成 Sparkle。
替换的 PR 我已经开过了(#19459,先在 macOS 的 canary 渠道试 Sparkle 差分更新),后面会接着把它做完。方案本身已经验证过:
- 我之前写过一个库 electron-sparkle-updater:Sparkle.framework 的 N-API 桥,加上 appcast 生成、EdDSA 签名和差分更新的发版工具链。
- 我自己的 Electron 应用 Kansoku 已经换成了 Sparkle。
- 我还给社区开源项目 Lody 也换成了 Sparkle(LodyAI/Lody#173)。
拿 Kansoku 最近几次发版的真实产物来看,全量 zip 大约 120 MB,Sparkle 的 delta 包小得多:
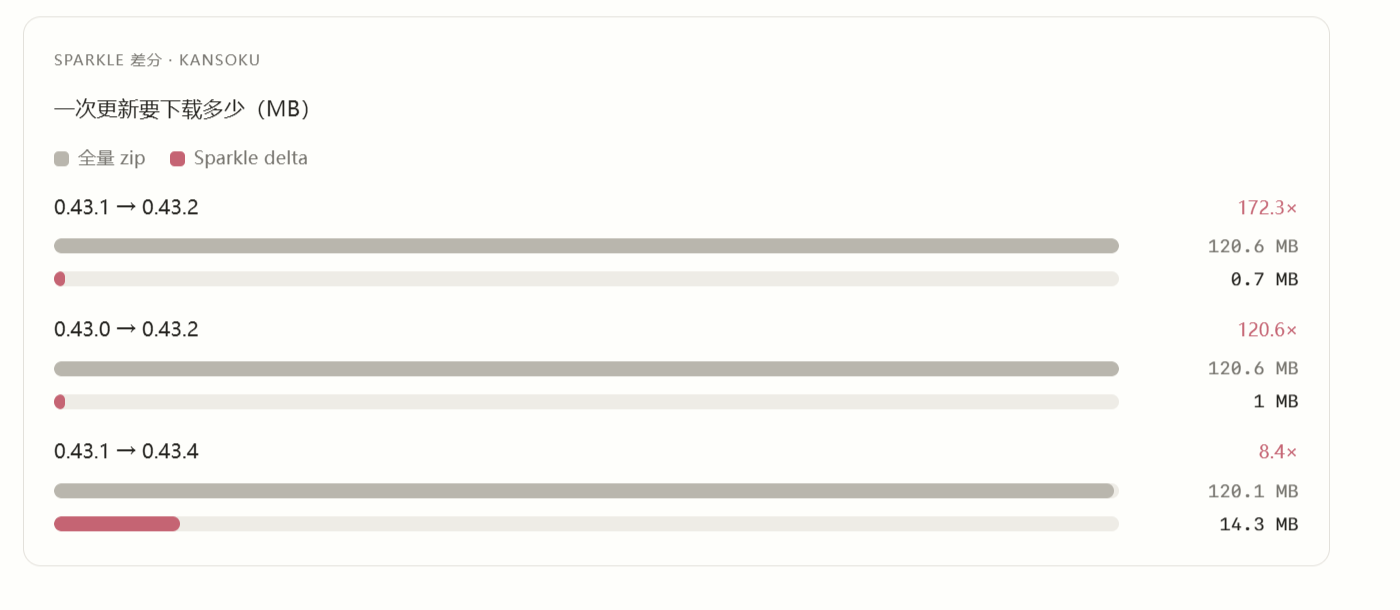
小版本之间只要 0.7–1 MB;跨了两个版本、改动也多的那次是 14.3 MB,仍然只有全量的八分之一左右。这就是开头说的,Sparkle 在解压后的 .app 上按文件做 diff,补丁大小跟着真实改动走。
安装也快得多。Sparkle 从退出 App 到新版本重新打开,几秒钟就能完成;electron-updater 有时候要十几秒才会打开。
我增强过的 Sparkle Updater 还支持跨多个版本打补丁,像游戏补丁一样一路打上去。原版 Sparkle 的每个 delta 只能从某一个旧版本直接升到最新版,发版时通常只给最近一两个版本生成 delta;落后好几个版本的用户,就只能下全量。增强版会把历史上每次发版留下的 delta 串起来:从 A 升到 E,依次打 A→B、B→C、C→D、D→E 四个补丁。
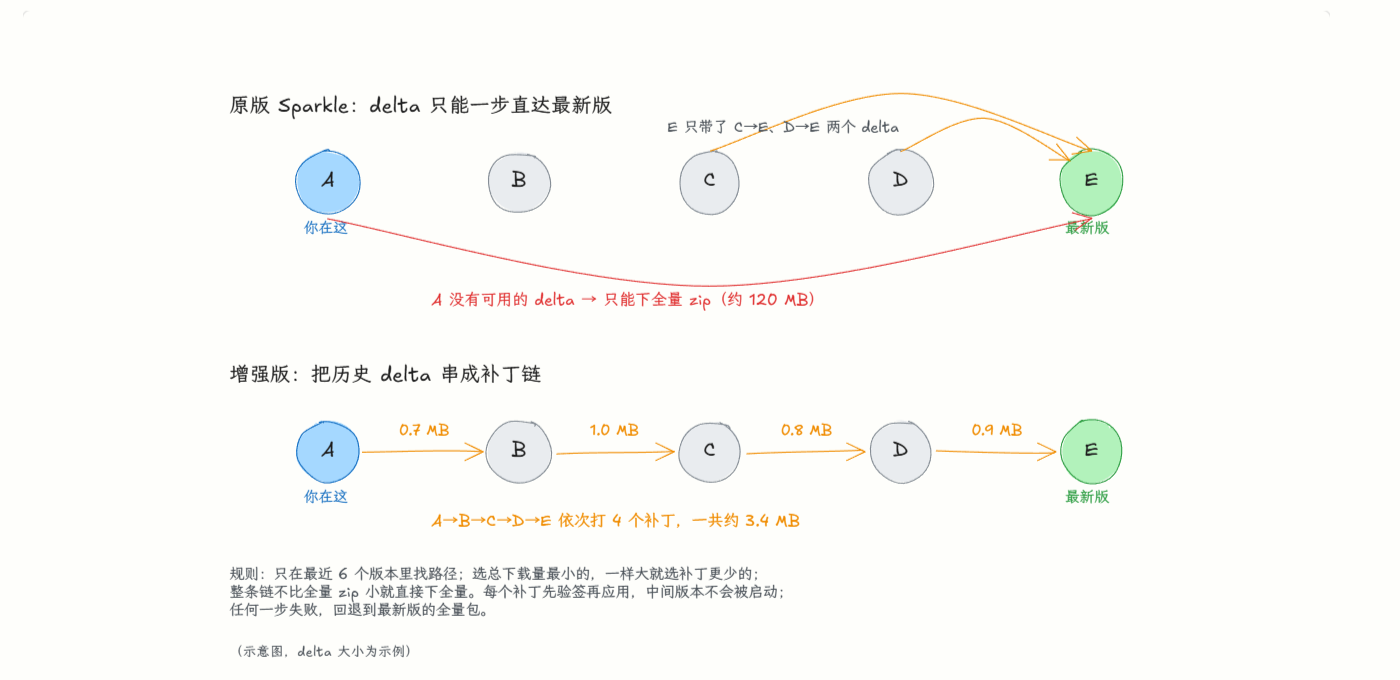
补丁链的代价是每一跳都要把整个 App 读几遍做校验。实测在 M4 Max 上,250 MB 的 App 每跳约 0.23 秒。但只要网速在 100 Mbps 以下,下载量的差距就远大于这点校验时间:100 Mbps 下,下载 261 MB 的全量包要 24 秒,20 跳、每跳 1 MB 的补丁链只要 8 秒。
Sparkle 只管 macOS。Windows 和 Linux 上 electron-updater 的差分更新(NSIS、AppImage)本身够用,继续保留。
评论交流
支持作者